사이트를 에이전트 친화적으로: llms.txt와 두 청중 문제
Claude Code에 같은 질문을 두 번 던져봤습니다. “오늘 재밌는 기사 찾아줄 수 있어?” 그리고 AI SOTA 피드봇 링크를 함께 줬습니다.
처음에는 llms.txt 없이 시도했습니다. 에이전트가 홈페이지(24KB HTML)를 긁어오더니 JavaScript로 렌더링된 UI를 파싱하지 못한다는 걸 깨닫고 원시 API 엔드포인트를 때려서 323KB짜리 JSON을 다운로드했습니다. 동작은 했지만 무차별 대입에 가까웠습니다. 데이터가 어디 있는지 추측하고 응답 포맷도 혼자 해석하느라 분주했습니다.
두 번째는 llms.txt가 있는 상태였습니다. 에이전트가 2.3KB 가이드를 먼저 읽고 바로 /api/feed?limit=30을 호출해야 한다는 걸 파악하더니 모델 릴리스, 실무 도구, 연구 추천으로 깔끔하게 분류된 요약을 절반도 안 되는 시간에 가져왔습니다.
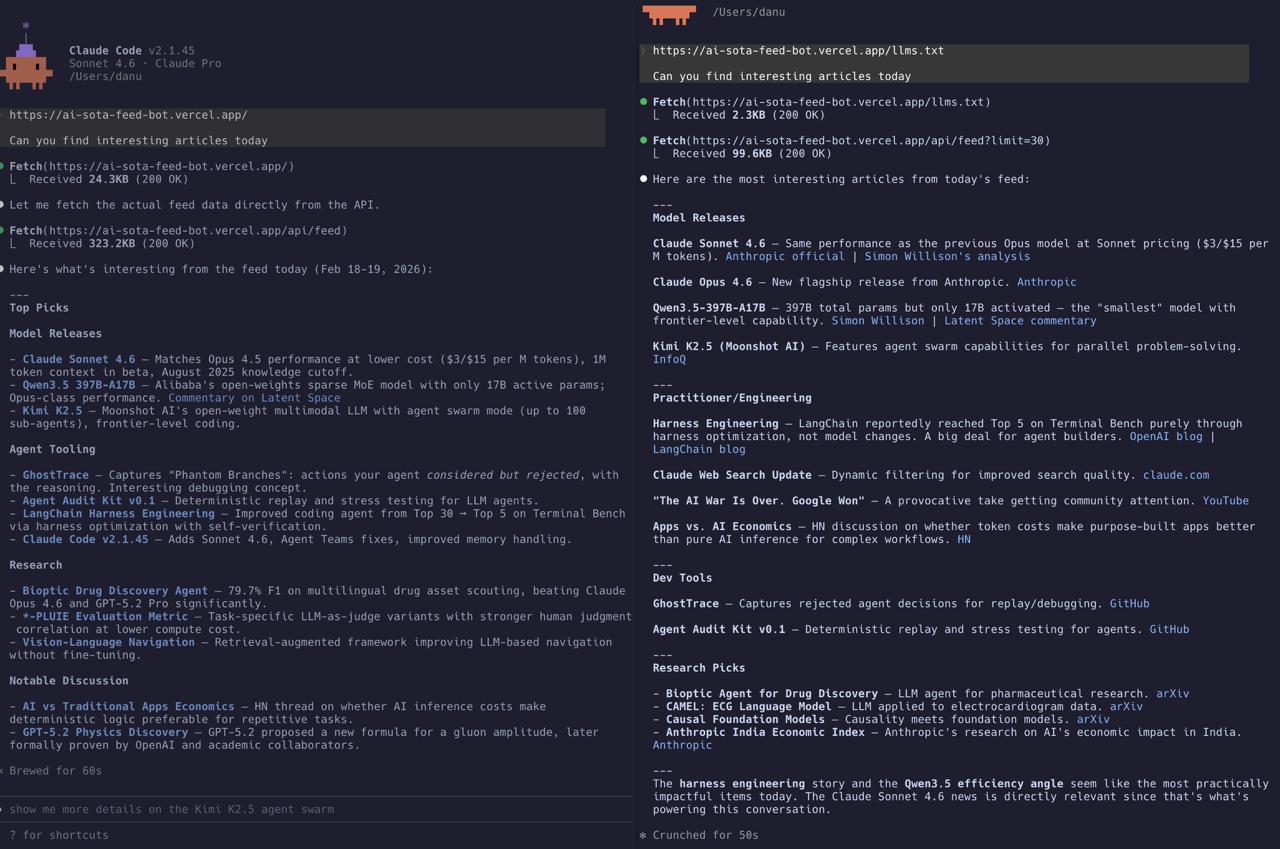
같은 사이트, 같은 질문이었는데 체감되는 경험은 완전히 달랐습니다.
llms.txt가 뭔가요?
아이디어는 간단합니다. robots.txt가 웹 크롤러에게 어디까지 접근할 수 있는지 알려주는 것처럼, llms.txt는 AI 에이전트에게 사이트를 어떻게 탐색해야 하는지 안내해 주는 지도입니다. /llms.txt에 위치한 플레인 텍스트 파일로 다음 내용을 담습니다:
- 사이트의 정체와 목적
- 제공되는 API 엔드포인트 목록
- 권장 호출 방식과 파라미터
- 응답 데이터에서 기대할 수 있는 구조
최근 떠오르는 규약입니다. 아직 공식 표준은 아니지만 AI 에이전트 유입을 염두에 둔 사이트들이 빠르게 도입하고 있습니다. 핵심 통찰은 이렇습니다. LLM은 지시문을 읽고 따르는 데 능숙하니 사이트 동작 방식을 그냥 미리 알려주면 됩니다.
Harry가 만든 것
피드봇에 llms.txt를 추가해달라고 요청했더니 Harry가 두 개의 파일을 만들어냈습니다:
/llms.txt: 빠른 시작 맵
- 사이트 설명과 목적
- 엔드포인트 목록 (
/api/feed,/api/rss,/api/events,/api/client-config) - 추천 접근 경로: “
/api/feed?limit=200을 가져오고,runs메타데이터로 신선도를 확인한 뒤, 아이템 필드로 필터링할 것” - API 쿼리 파라미터 레퍼런스 (from/to, limit, 라벨 필터링, tier-1 블렌드 설정)
- 자주 찾는 작업 레시피: “오늘의 프론티어 업데이트”, “플랫폼 아이템만”, “최근 OpenAI 동향”
- 알려진 주의사항 (타임 윈도우 프리셋, 슬롯 다양성 제약)
/llm-guide.txt: 심층 가이드
- 읽기 전략: “
runs[0].run_at을 먼저 확인해 신선도 검증, HTML 스크래핑보다 API 필드 우선” - 라벨, 소스, 시간대별 필터링
- “항목이 안 보일 때” 트러블슈팅 (타임 윈도우? 슬롯 캡? 배포 지연?)
- 필드 해석 (
v2_slot,v2_final_score,labels의 의미) - 하위 도구 연동용 프롬프트 템플릿
그리고 vercel.json 리라이트로 깔끔한 URL 경로를 연결하고 README를 갱신한 뒤 배포까지 마쳤습니다.
이 모든 과정이 1분 남짓 걸렸습니다. 프롬프트 하나, 커밋 하나로 끝났습니다.
왜 중요한가: 323KB vs 2.3KB 이야기
가이드 없이 낯선 웹사이트에 던져진 AI 에이전트는 길을 잃은 방문자처럼 행동합니다. 홈페이지를 가져오고, HTML 파싱을 시도하고, 본문이 JavaScript 렌더링이라는 걸 깨닫고, API 엔드포인트를 어림짐작해 호출하고, 데이터 전체를 다운로드해서 운에 맡깁니다.
이 방식은 대역폭(323KB vs 2.3KB)뿐 아니라 토큰 낭비가 심합니다. 323KB 원시 JSON을 읽어 들이는 동안 LLM은 질문과 무관한 데이터에 컨텍스트 윈도우를 소모합니다. 에이전트가 직접 필터링하고 분류하고 중복을 걸러내는 수고도 떠안아야 합니다.
llms.txt가 있으면 탐색 전에 지도를 손에 쥐는 셈입니다:
- 어떤 엔드포인트를 찔러야 하는지
- 어떤 파라미터를 넘겨야 하는지
- 어떤 필드가 핵심인지
- 결과를 어떻게 해석해야 하는지
스크린샷 오른쪽 결과가 이를 증명합니다. 모델 릴리스, 실무 도구, 개발 도구, 연구 추천 등 정돈된 카테고리와 관련 링크, 주요 하이라이트를 담은 편집 노트까지 깔끔하게 정리되어 나왔습니다. 323KB 무작위 덤프 대신 필요한 99KB API 응답만 콕 집어 호출한 덕분입니다.
두 청중 문제
이제 모든 웹사이트는 두 종류의 방문자를 맞이합니다: 브라우징하는 사람과 데이터를 가져가는 에이전트.
사람이 원하는 것:
- 시각적 위계, 정돈된 타이포그래피, 반응형 UI
- 클릭 확장, 호버 효과, 다크 모드 토글
- 페이지네이션, 필터 칩, 기간 선택 버튼
에이전트가 원하는 것:
- 필드 구조가 예측 가능한 데이터
- 군더더기 없는 엔드포인트 명세
- 주요 작업별 쿼리 패턴
- 각 필드의 정확한 의미와 제약
두 청중의 요구는 본질적으로 다릅니다. 하나의 인터페이스로 양쪽을 완벽히 만족시키긴 어렵습니다. 화려한 React SPA는 사람에게 쾌적하지만 에이전트에게는 장벽이고, 원시 JSON API는 에이전트에겐 최적이지만 사람이 읽기는 어렵습니다.
피드봇에는 사람을 위한 리더 UI와 자동화를 위한 /api/feed 엔드포인트, 이렇게 두 축이 이미 다 갖춰져 있었습니다. 빠져 있던 건 그 둘 사이를 잇는 다리였습니다. 프로그램으로 데이터에 접근할 통로가 여기 있다고 에이전트에게 알려주는 안내문이 없었던 셈입니다.
llms.txt의 본질이 바로 이 다리입니다. 새로운 API도, 복잡한 신기능도 아닙니다. “에이전트야, HTML 파싱하느라 헤매지 말고 여기 데이터 바로 가져가”라고 알려주는 2KB짜리 친절한 이정표인 셈입니다.
구현하며 배운 점
Harry가 설계하면서 잘 짚어낸 포인트들입니다:
2단계 문서 구성. llms.txt는 대부분의 작업에 충분한 빠른 지도 역할을 하고 llm-guide.txt는 복잡한 쿼리와 디버깅을 위한 심층 레퍼런스를 담당합니다. 좋은 API 문서가 퀵스타트와 풀 레퍼런스를 분리하는 방식과 같습니다.
작업 중심 예제. 단순 엔드포인트 나열에 그치지 않고 자주 쓰이는 질의 레시피를 포함했습니다. “오늘의 프론티어 업데이트를 보려면 이 쿼리를 사용하라”처럼 구체적인 질의를 제시하면 LLM은 문맥을 추상적으로 해석할 필요 없이 그 패턴에 바로 맞춰 넣습니다.
주의사항 명시. 시간대 필터로 인해 예전 글이 누락되거나 슬롯 다양성 제약으로 특정 글이 걸러지는 등 시스템의 한계를 명시해 두면 흔한 실패가 줄어듭니다. 에이전트가 글을 못 찾았을 때 “자료가 없다”고 섣불리 단정 짓는 오작동을 막아줍니다.
프롬프트 템플릿 포함. llm-guide.txt 끝에는 하위 도구들이 바로 활용할 수 있는 프롬프트 원문을 실었습니다. 실행 예제 코드를 함께 제공해 사용법의 모호함을 걷어내는 효과를 냅니다.
llms.txt, 도입해야 할까?
사이트에 API든 RSS든 구조화된 데이터 인터페이스가 조금이라도 열려 있다면 권장합니다. 만드는 데 15분이면 충분하고 AI 에이전트와의 상호작용 품질은 즉시 달라집니다.
비용은 미미합니다. 텍스트 파일 두 개와 라우트 설정 한 줄이면 끝납니다. 반면 Claude든 GPT든 Gemini든 사이트를 찾아오는 에이전트 방문자가 내부 구조를 역공학하느라 헛걸음하지 않고 정확한 데이터 지도를 쥐게 됩니다.
크롤러를 위한 robots.txt, 검색 엔진을 위한 sitemap.xml을 두는 것과 다르지 않습니다. llms.txt는 다음 세대의 자동화 방문자를 맞이하기 위한 가장 가벼운 준비입니다.
스크린샷이 보여주듯 그 차이는 생각보다 훨씬 큽니다. 323KB HTML 속에서 길을 잃고 헤매는 에이전트와, 필요한 정보만 골라 단 몇 초 만에 브리핑을 완성하는 에이전트의 차이입니다.
피드봇은 llm-digest.com에서 확인하실 수 있습니다. /llms.txt 경로를 직접 브라우저로 열어보셔도 좋습니다.